
 Sovelluskehitys ja arkkitehtuuri
 Data ja analytiikka
 Tekoäly (AI)
 Verkkokauppa
 Järjestelmäintegraatiot
 Jatkuvat palvelut
 Teollisuus
 Kaupan ala
 Liikenne ja logistiikka
 Meri- ja veneteollisuus
 Shopify
Datan laatu puhututtaa nyt enemmän kuin ennen. Tämä on seurausta muutoksesta, jonka monet organisaatiot näkevät omassa arjessaan: tekoälykokeiluista on siirretty katse operatiiviseen toimintaan ja prosesseihin. Kun data ohjaa automaatiota, AI-ratkaisuja ja operatiivista päätöksentekoa, on laatu muutakin, kuin raportoinnin tukikysymys. Datan laadusta tulee osa koko yrityksen toiminnan luotettavuutta.
Omalla työpöydälläni tämä näkyy varsin käytännöllisenä kysymyksenä: missä kohtaa datan laatua voi oikeasti valvoa ja miten se tehdään?
Unohdetaan ideaalitilanne. Mennään siihen todellisuuteen, jossa organisaatiot elävät. Data tulee vanhoista järjestelmistä, CSV-tiedostoista, integraatioista, monenlaisista sensoreista ja manuaalisista prosesseista. Usein epäselvien omistajuuksien kautta. Tässä todellisuudessa keskitetty datatiimi pyrkii tekemään parhaansa, mutta päätyy usein siivoamaan muiden jälkiä.
Yllä kuvattu on monelle organisaatiolle tuttu tilanne. Datan laatuun liittyvä työ on pistemäistä ja reaktiivista. Virhe huomataan esimerkiksi vasta raportilla, aamun tarkastuksessa tai silloin, kun joku liiketoiminnassa kysyy: miksi tämä luku näyttää oudolta?
Raportointimaailmassa tämä oli jo tarpeeksi hankalaa ja nyt kun data alkaa yhä enemmän määrissä ohjata automaatiota, tekoälyratkaisuja ja operatiivisia päätöksiä, saman toimintamallin rajat ovat tulleet nopeasti vastaan.
Myös riippumaton tutkimus tukee havaintoa siitä, että datan laatu on monen tekijän summa. Foidl et al. (2024) tunnistivat yhteensä 41 erilaista dataputkien laatuun vaikuttavaa tekijää, jotka liittyvät muun muassa itse dataan, integraatioiden ja alustan kehitykseen, laajemmin infrastruktuuriin sekä elinkaaren hallintaan ja datan prosessointiin. Käytännön työn näkökulmasta tämä tuntuu tutulta: laatu ei synny yhdessä tarkistuspisteessä, vaan monen teknisen, organisatorisen ja prosessiin liittyvän tekijän yhteisvaikutuksena. Samaan suuntaan vie myös uudempi data-arkkitehtuuria käsittelevä tutkimus, jossa korostetaan, että datan laadun tarkistukset kannattaa sitoa jo arkkitehtuuriin eikä jättää irrallisiksi jälkikäteen tehtäviksi kontrolleiksi (Abughazala et al., 2026).
Olisi helppo vastata: laittakaa governance kuntoon. Kyllä, mutta miten? Mistä aloittaa? Tässä ehdotus: data contractit. Selitän tarkemmin alla.
Ensimmäinen hallittava kohta data-alustan kontekstissa
Datan laatu syntyy usein siellä, missä data syntyy: liiketoimintaprosessissa, lähdejärjestelmässä ja monesti ihmisen tekemässä kirjauksessa. Tähän voi vaikuttaa johtamisella, koulutuksella, selkeillä vastuilla, hyvillä ohjeilla, toimivilla prosesseilla ja paremmilla järjestelmillä.
Tämä työ on tärkeää.
Se on kuitenkin usein myös hidasta.
Data-alustan näkökulmasta ensimmäinen aidosti hallittava kohta on monesti vasta se, kun data saapuu alustalle.
Yksinkertaistettuna prosessi näyttää tältä:
Lähdejärjestelmä / tiedosto / API → intake → staging / landing → transformointi → curated data → raportointi / AI / automaatio
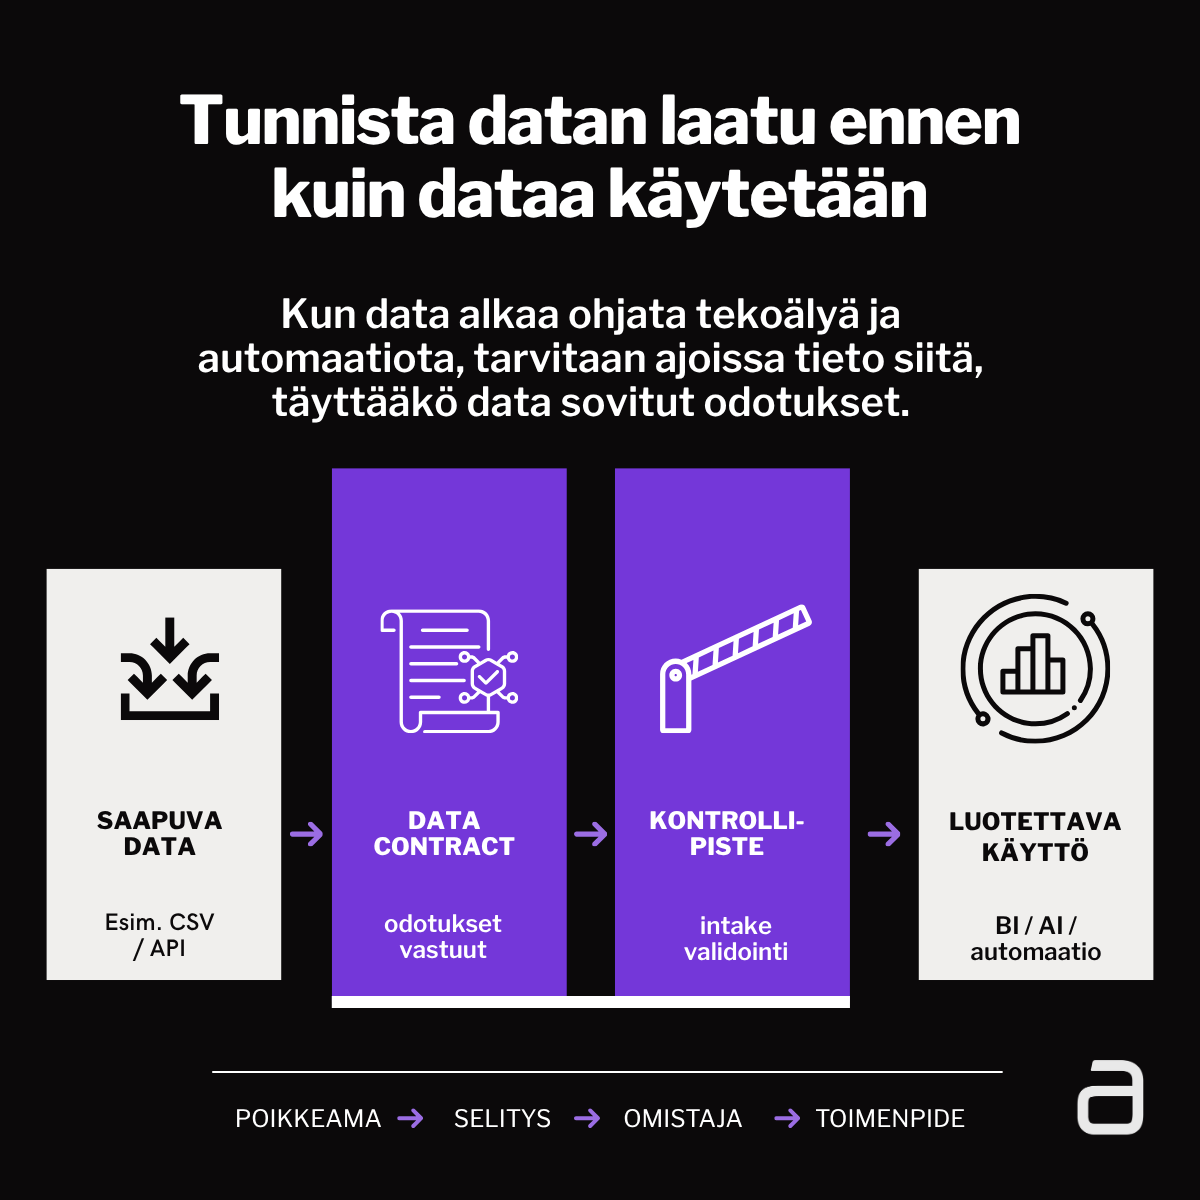
Intake-vaiheessa voidaan tarkistaa, tuliko data ylipäätään, tuliko sitä odotettu määrä, vastaako rakenne sovittua ja näyttävätkö arvot uskottavilta suhteessa historiaan. Se ei vielä ratkaise kaikkea datan laatua, mutta se antaa mahdollisuuden havaita poikkeamat ennen kuin data jatkaa pidemmälle raportointiin, automaatioon tai tekoälyn käyttöön.
Tämä ei vielä korjaa kaikkea. Eikä sen tarvitsekaan. Ensimmäinen tehtävä on havaita ja selittää.
Jos tiedoston rivimäärä on yhtäkkiä kymmenesosa normaalista, se on tieto. Jos numerokenttään tulee sähköpostiosoite, se on tieto. Jos myyntisumma poikkeaa rajusti aiemmasta tasosta, sekin on tieto. Arvo syntyy siitä, että tieto ei jää vain tekniseksi virheilmoitukseksi, vaan siitä muodostuu ymmärrettävä toimintapolku: mitä tapahtui, missä se havaittiin, mihin se vaikuttaa ja kenelle asia kuuluu.
Data contract ei ole pelkkä dokumentti
Data contract -käsite kuulostaa helposti tekniseltä tai lakiosaston asialta. Tässä yhteydessä kyse on kuitenkin hyvin käytännöllisestä asiasta. Jokaiselle tärkeälle datavirralle kuvataan, mitä siltä odotetaan.
Mistä data tulee? Missä muodossa? Kuinka usein? Mitkä kentät ovat pakollisia? Mikä on normaali rivimäärä? Kuka omistaa datan? Mitä tehdään, jos odotus ei täyty?
Kun asia kuvataan koneluettavasti, esimerkiksi versionhallittuna YAML- tai JSON-muotoisena määrittelynä, se ei ole enää pelkkä dokumentti. Siitä voidaan johtaa tarkistuksia, testejä, monitorointia ja häiriöiden ohjausta. Samalla syntyy yhteinen kieli datan tuottajien, integraatiotiimin, data-alustan ja liiketoiminnan välille.
Tässä piilee mielestäni iso muutos. Datan laatu ei jää datatiimin yksin kannateltavaksi. Laatu alkaa näkyä sopimuksena siitä, mitä dataa organisaatio voi käyttää ja millä edellytyksillä.
Riittävän hyvä alku
Tässä kohtaa on tärkeä olla rehellinen. Datasopimus ei ratkaise koko organisaation datan laatua. Se ei korjaa lähdejärjestelmiä, rakenna täydellistä käsitemallia eikä automatisoi kaikkea virheenkorjausta. Se ei myöskään korvaa tai ole kattava data governance -malli.
Hyvä ensimmäinen askel on valita muutama datavirta, joilla on selkeä liiketoiminnallinen merkitys. Niille kuvataan data contractit, määritellään ensimmäiset tarkistukset ja sovitaan, miten poikkeamat ohjataan eteenpäin. Näin syntyy heti hyödynnettävää, eikä alku jää abstraktiksi data governance -suunnitelmaksi paperilla. Syntyy pieni, konkreettinen kontrollipiste, joka kertoo ajoissa, voiko dataan luottaa. Yksi datavirta kerrallaan. Edelleen on helppo todistaa, miten malli toimii laajennettuna.
Tekoäly voi myöhemmin auttaa poikkeamien selittämisessä, vaikutusten tiivistämisessä ja edelleen korjausehdotusten muodostamisessa. Mutta ihan ensin tarvitaan havaintopisteet. Muuten tekoäly selittää epäselvää tilannetta epäselvän datan pohjalta.
Lähteet
Abughazala, M., Sharaf, M., & Muccini, H. (2026). Architecting data-intensive applications: From architectural design to data quality. Information and Software Technology, 196, 108156.
Foidl, H., Golendukhina, V., Ramler, R., & Felderer, M. (2024). Data pipeline quality: Influencing factors, root causes of data-related issues, and processing problem areas for developers. Journal of Systems and Software, 207, 111855.
Kirjoittajasta
Tuuli on Ambientian data- ja tekoälyjohtaja, joka auttaa organisaatioita viemään dataa ja tekoälyä käytännön liiketoimintaan. Hänen työssään korostuvat datan hyödyntämisen edellytykset: selkeä ongelman määrittely, ihmislähtöinen suunnittelu, toimivat prosessit sekä luotettava ja saavutettava data, jonka varaan päätöksiä ja automaatiota voidaan rakentaa. Tuuli tukee organisaatioita myös datan ja tekoälyn hallintamallien rakentamisessa ja konkretisoinnissa.
Tuulilla on yli 25 vuoden kokemus digitaalisen liiketoiminnan kehittämisestä ohjelmoinnin, asiakaskokemuksen, johtamisen ja liiketoiminnan kehittämisen parissa. Aiempi tausta luovana johtajana näkyy tavassa yhdistää teknologia, ihmiset ja liiketoiminnan tavoitteet ymmärrettäviksi kokonaisuuksiksi.

Tilaa sisältömme
Haluatko sisältömme sähköpostiisi? Meillä on tarjolla muun muassa tietoa palvelunhallinnasta ja asiakaskokemuksen kehittämisestä
Lisää aiheeseen liittyvää

tekoäly
Datan laatu AI-hankkeissa – millaista dataa tekoäly tarvitsee?
Millaista dataa tekoäly tarvitsee? Lue, miten datan laatu, konteksti ja metadata vaikuttavat AI-hankkeen onnistumiseen.
Lue lisää

Blogi
Paranna datan laatua – luo uusia polkuja liiketoiminnalle
Parempi tiedonhallinta vahvistaa datan laatua. Millaisia hyötyjä se tuo mukanaan?
Lue lisää